Azure AI Search Custom Web API를 활용한 외부 임베딩 모델 통합 벡터화 가이드
Azure AI Search Custom Web API skill로 외부 임베딩 모델을 연결하는 방법을 설명합니다.
Azure OpenAI 없이, 자체 호스팅한 오픈소스 임베딩 모델을 Custom Web API Skill/Vectorizer로 AI Search Integrated Vectorization에 연동하는 방법
📌 핵심 요약
| 항목 | 내용 |
|---|---|
| 목적 | Azure OpenAI 없이 AI Search Integrated Vectorization 구현 |
| 검증 모델 | BAAI/bge-m3, Qwen/Qwen3-Embedding-0.6B |
| 호스팅 | FastAPI 서버를 Container Apps (TLS 자동) 또는 AKS + cert-manager (Let's Encrypt)로 HTTPS 노출 |
| 핵심 검증 | Custom Web API Skill(인덱싱) + Custom Web API Vectorizer(쿼리) 동작 확인 |
| 모델 비교 | BGE-M3 vs Qwen3-Embedding-0.6B |
| 인덱서 결과 | 5건 처리 / 0건 실패 |
🔍 배경 및 문제 정의
Azure AI Search의 Integrated Vectorization은 인덱싱 시점과 쿼리 시점에 자동으로 텍스트를 벡터로 변환하는 기능이다. 공식 문서에서 지원하는 벡터라이저는 Azure OpenAI, AI Foundry Model Catalog, AML 등이 있지만, Custom Web API 옵션을 활용하면 어떤 임베딩 모델이든 연동 가능하다.
이 가이드는 다음 상황에서의 검증을 목적으로 한다:
- Azure OpenAI 리소스가 없거나 사용할 수 없는 구독 환경
- AI Foundry Marketplace 구매가 정책으로 차단된 환경 (MCAPS 등)
- 오픈소스 모델을 직접 호스팅하여 비용을 줄이고 싶은 경우
- 특정 언어/도메인에 최적화된 임베딩 모델을 사용하고 싶은 경우
🔍 아키텍처
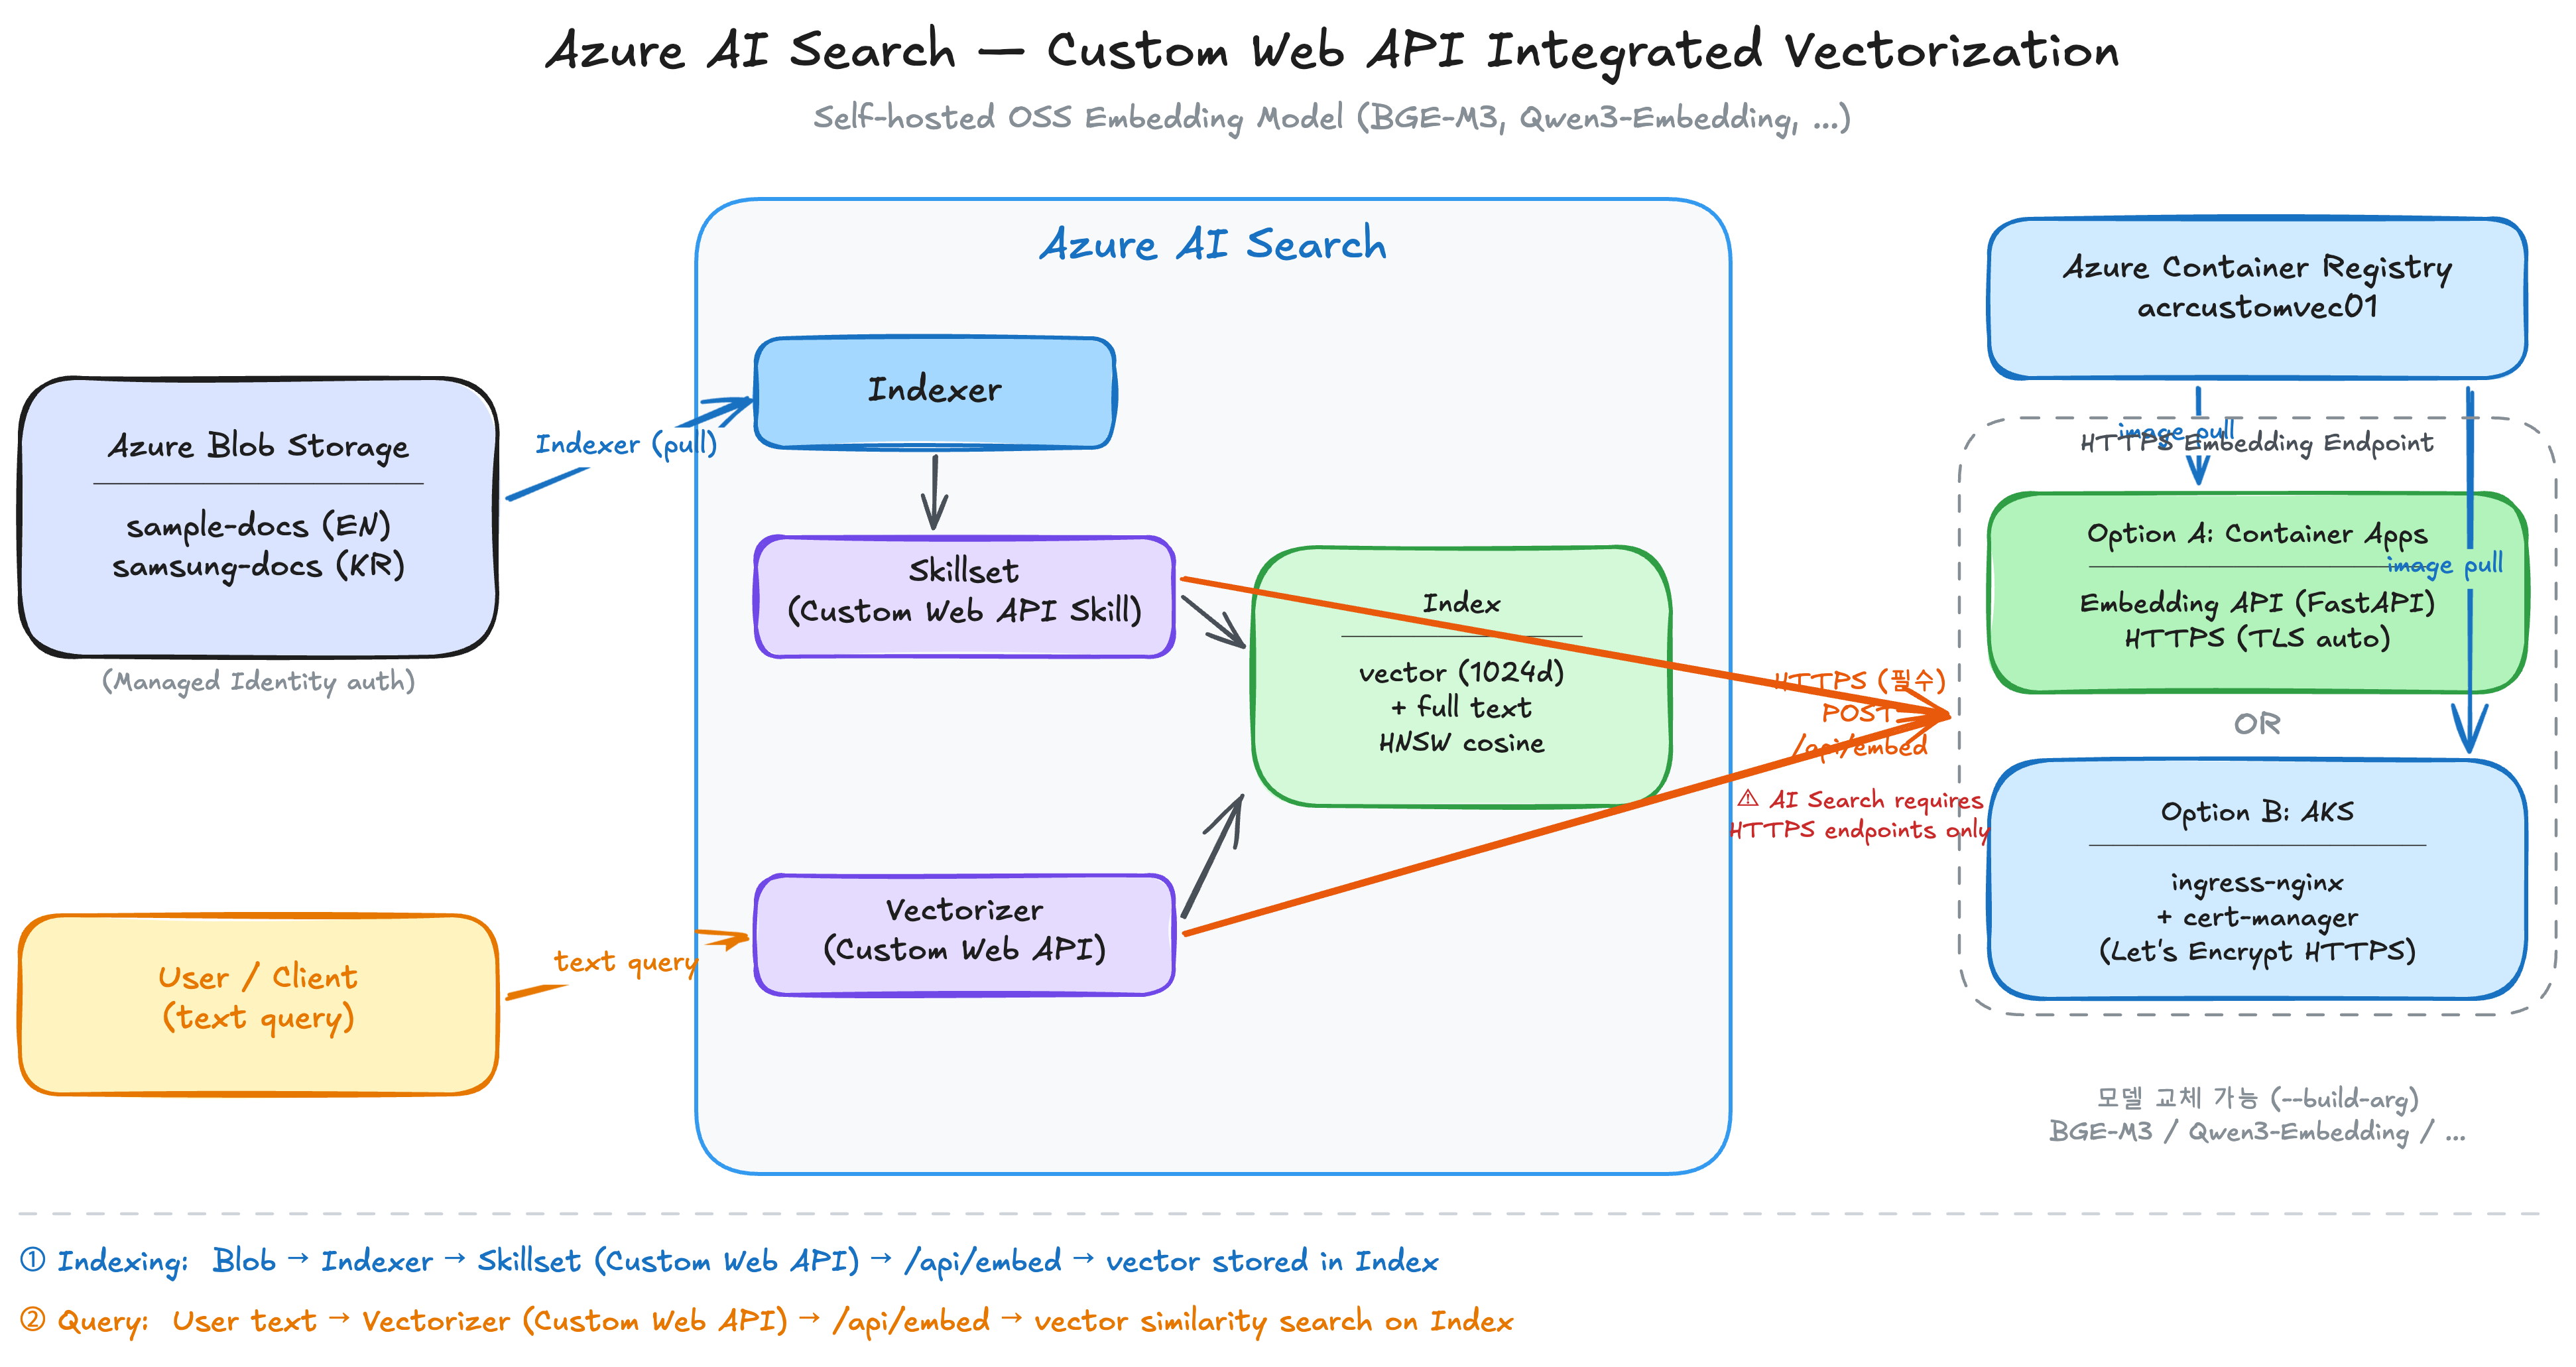
데이터 흐름
인덱싱 시점 (Indexer → Skillset → Index)
Azure Blob Storage    →    Indexer    →    Custom Web API Skill    →    BGE-M3 /api/embed    →    벡터 + 텍스트 인덱스 저장
(sample-docs)              (pull)          (bge-m3-skillset)            (HTTPS)                    (sample-vector-idx)
쿼리 시점 (Vectorizer)
사용자 텍스트 쿼리    →    Custom Web API Vectorizer    →    BGE-M3 /api/embed    →    벡터 유사도 검색
                           (bge-m3-vectorizer)               (HTTPS)                    (HNSW cosine)
구성 요소
| 구성 요소 | 리소스 | 세부 사항 |
|---|---|---|
| AI Search | search-example-koreacentral-01 (Standard) |
인덱스, 스킬셋, 인덱서, 벡터라이저 |
| 임베딩 API | FastAPI (embedding-api/app.py) |
Custom Web API Skill 계약 준수 |
| HTTPS 엔드포인트 (A) | Container Apps ca-embedding-example-01 |
TLS 자동 적용, 설정 최소 |
| HTTPS 엔드포인트 (B) | AKS Ingress embed.{IP}.nip.io |
ingress-nginx + cert-manager + Let's Encrypt |
| 컨테이너 레지스트리 | acrexamplekrc01 (Basic) |
Docker 이미지 저장소 |
| 스토리지 | stexamplekrc01 |
Blob 컨테이너 sample-docs (샘플 문서) |
| Region | koreacentral | 모든 리소스 동일 리전 |
✅ 구성 절차
1. 임베딩 API 이미지 빌드 및 푸시
ACR Tasks를 사용하여 로컬 Docker 없이 클라우드에서 빌드한다. BGE-M3 모델 가중치(~2.3GB)를 빌드 타임에 다운로드하여 Cold start를 방지한다.
az acr build --registry acrexamplekrc01 \
  --image bge-m3-embedding:latest \
  --file embedding-api/Dockerfile \
  embedding-api/
2. HTTPS 엔드포인트 구성
AI Search의 Custom Web API Skill과 Custom Web API Vectorizer 모두 HTTPS URI만 허용한다 ("Only the https URI scheme is allowed"). HTTP 엔드포인트를 지정하면 스킬셋/인덱서 실행 시 오류가 발생한다.
- Container Apps — 배포 시 TLS가 자동 적용되므로 별도 설정 불필요
- AKS — 기본은 HTTP만 노출하므로 cert-manager + Let's Encrypt로 TLS 인증서를 자동 발급해야 한다
두 가지 방식 중 선택하여 구성한다.
Option A. Container Apps (설정 최소, TLS 자동)
Container Apps는 이미지를 배포하면 HTTPS가 자동 적용된다.
# Container Apps 환경 생성
az containerapp env create --name cae-example-koreacentral-01 \
  --resource-group rg-example-koreacentral-01 --location koreacentral

# 임베딩 API 배포 (외부 HTTPS ingress)
az containerapp create --name ca-embedding-example-01 \
  --resource-group rg-example-koreacentral-01 --environment cae-example-koreacentral-01 \
  --image acrexamplekrc01.azurecr.io/bge-m3-embedding:latest \
  --registry-server acrexamplekrc01.azurecr.io \
  --target-port 8000 --ingress external \
  --cpu 2 --memory 4Gi --min-replicas 1 --max-replicas 1
# FQDN 확인
az containerapp show --name ca-embedding-example-01 \
  --resource-group rg-example-koreacentral-01 \
  --query properties.configuration.ingress.fqdn -o tsv
# ca-embedding-example-01.example.koreacentral.azurecontainerapps.io
Option B. AKS + ingress-nginx + cert-manager (Let's Encrypt)
AKS를 이미 운영 중이면 Container Apps 없이 AKS에서 직접 HTTPS를 제공할 수 있다.
# ingress-nginx 설치
helm install ingress-nginx ingress-nginx/ingress-nginx \
  --namespace ingress-nginx --create-namespace \
  --set controller.replicaCount=1 \
  --set controller.service.annotations."service\.beta\.kubernetes\.io/azure-load-balancer-health-probe-request-path"="/healthz" \
  --wait
# cert-manager 설치
helm install cert-manager jetstack/cert-manager \
  --namespace cert-manager --create-namespace \
  --set crds.enabled=true --wait
Ingress LoadBalancer IP를 확인하여 nip.io 도메인을 구성한다. nip.io는 IP 주소를 자동으로 DNS로 매핑하므로 별도 도메인 구매가 불필요하다.
# Ingress LoadBalancer IP 확인
INGRESS_IP=$(kubectl get svc -n ingress-nginx ingress-nginx-controller \
  -o jsonpath='{.status.loadBalancer.ingress[0].ip}')
echo "Domain: embed.${INGRESS_IP}.nip.io"
# Domain: embed.<INGRESS_IP>.nip.io
k8s/ingress.yaml의 host를 위 도메인으로 설정한 뒤 적용한다.
cert-manager가 Let's Encrypt HTTP-01 챌린지를 자동 처리하여 인증서를 발급한다.
# 인증서 발급 확인 (READY: True)
kubectl get certificate
# NAME         READY   SECRET       AGE
# bge-m3-tls   True    bge-m3-tls   47s
HTTPS 엔드포인트 확인
선택한 방식에 따라 엔드포인트가 달라진다.
# Option A (Container Apps)
curl -s https://ca-embedding-example-01.example.koreacentral.azurecontainerapps.io/health

# Option B (AKS + Let's Encrypt)
curl -s "https://embed.${INGRESS_IP}.nip.io/health"
# {"status":"ok","model":"BAAI/bge-m3"}
비교
| Container Apps | AKS + cert-manager | |
|---|---|---|
| HTTPS | 자동 (TLS 설정 불필요) | ingress-nginx + cert-manager + Let's Encrypt |
| 추가 비용 | Container Apps 과금 | AKS 이미 있으면 추가 비용 없음 |
| 셋업 복잡도 | 낮음 (~5분) | 높음 (Helm + DNS + 인증서 확인) |
| 인증서 관리 | 자동 | cert-manager 자동 갱신 (90일) |
3. AI Search 데이터 소스 생성
이후 단계에서 사용할 환경변수를 먼저 설정한다.
Managed Identity 역할 부여 + 데이터 소스 생성
스토리지에 Shared Key Access가 Azure Policy로 차단된 경우, `ResourceId` 형식의 연결 문자열로 Managed Identity 인증을 사용한다.# AI Search MI에 Storage Blob Data Reader 역할 부여
az role assignment create \
--role "Storage Blob Data Reader" \
--assignee-object-id $(az search service show --name search-example-koreacentral-01 \
--resource-group rg-example-koreacentral-01 --query identity.principalId -o tsv) \
--assignee-principal-type ServicePrincipal \
--scope $(az storage account show --name stexamplekrc01 \
--resource-group rg-example-koreacentral-01 --query id -o tsv)
# 데이터 소스 생성 (Managed Identity 인증)
curl -X POST "$SEARCH_URL/datasources?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "sample-docs-ds",
    "type": "azureblob",
    "credentials": {
      "connectionString": "ResourceId=/subscriptions/{sub}/resourceGroups/rg-example-koreacentral-01/providers/Microsoft.Storage/storageAccounts/stexamplekrc01/;"
    },
    "container": {"name": "sample-docs"}
  }'
4. AI Search 인덱스 생성 (벡터 필드 + Custom Vectorizer)
인덱스에 contentVector 벡터 필드(1024차원, HNSW cosine)를 정의하고, Custom Web API Vectorizer를 등록하여 쿼리 시점에 텍스트 → 벡터 자동 변환이 이루어지도록 설정한다.
인덱스 생성 curl
# Option A: Container Apps FQDN
# EMBED_URL="https://ca-embedding-example-01.example.koreacentral.azurecontainerapps.io"
# Option B: AKS Ingress
: "${INGRESS_IP:?Set INGRESS_IP to the Ingress LoadBalancer IP}"
EMBED_URL="https://embed.${INGRESS_IP}.nip.io"

curl -X PUT "$SEARCH_URL/indexes/sample-vector-idx?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "sample-vector-idx",
    "fields": [
      {"name": "id", "type": "Edm.String", "key": true, "filterable": true},
      {"name": "content", "type": "Edm.String", "searchable": true},
      {"name": "title", "type": "Edm.String", "searchable": true, "filterable": true},
      {"name": "contentVector", "type": "Collection(Edm.Single)", "searchable": true,
       "dimensions": 1024, "vectorSearchProfile": "bge-m3-profile"}
    ],
    "vectorSearch": {
      "algorithms": [{"name": "hnsw-algo", "kind": "hnsw",
        "hnswParameters": {"m": 4, "efConstruction": 400, "efSearch": 500, "metric": "cosine"}}],
      "profiles": [{"name": "bge-m3-profile", "algorithm": "hnsw-algo",
        "vectorizer": "bge-m3-vectorizer"}],
      "vectorizers": [{
        "name": "bge-m3-vectorizer",
        "kind": "customWebApi",
        "customWebApiParameters": {
          "uri": "'$EMBED_URL'/api/embed",
          "httpMethod": "POST"
        }
      }]
    }
  }'
5. 스킬셋 생성 (인덱싱 시점 벡터화)
Custom Web API Skill을 통해 인덱서가 문서를 처리할 때 BGE-M3 API를 호출하여 벡터를 생성한다.
스킬셋 생성 curl
curl -X PUT "$SEARCH_URL/skillsets/bge-m3-skillset?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "bge-m3-skillset",
    "skills": [{
      "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
      "name": "bge-m3-embedding-skill",
      "uri": "'$EMBED_URL'/api/embed",
      "httpMethod": "POST",
      "timeout": "PT60S",
      "batchSize": 10,
      "context": "/document",
      "inputs": [{"name": "text", "source": "/document/content"}],
      "outputs": [{"name": "vector", "targetName": "contentVector"}]
    }]
  }'
6. 인덱서 생성 및 실행
데이터 소스 → 스킬셋 → 인덱스를 연결하는 인덱서를 생성한다. 생성 즉시 자동 실행된다.
인덱서 생성 curl
curl -X PUT "$SEARCH_URL/indexers/sample-vector-indexer?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "sample-vector-indexer",
    "dataSourceName": "sample-docs-ds",
    "targetIndexName": "sample-vector-idx",
    "skillsetName": "bge-m3-skillset",
    "fieldMappings": [
      {"sourceFieldName": "metadata_storage_path", "targetFieldName": "id",
       "mappingFunction": {"name": "base64Encode"}},
      {"sourceFieldName": "metadata_storage_name", "targetFieldName": "title"}
    ],
    "outputFieldMappings": [
      {"sourceFieldName": "/document/contentVector", "targetFieldName": "contentVector"}
    ]
  }'
🧪 검증 결과
인덱서 실행 결과
5건의 샘플 문서(Azure 서비스 설명)가 Custom Web API Skill을 통해 BGE-M3 임베딩과 함께 인덱싱 완료.
벡터 검색 — "How does Azure handle container orchestration?"
쿼리 시점에 텍스트가 Custom Web API Vectorizer를 통해 자동으로 벡터로 변환되어 유사도 검색이 수행된다.
curl -X POST "$SEARCH_URL/indexes/sample-vector-idx/docs/search?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "count": true, "select": "title, content",
    "vectorQueries": [{
      "kind": "text",
      "text": "How does Azure handle container orchestration?",
      "fields": "contentVector", "k": 3
    }]
  }'
| 순위 | Score | 문서 | 판단 |
|---|---|---|---|
| 1 | 0.7421 | azure-kubernetes.txt | ✅ 컨테이너 오케스트레이션의 핵심 서비스 |
| 2 | 0.7404 | azure-container-apps.txt | ✅ 컨테이너 관련 서비스 |
| 3 | 0.7031 | azure-functions.txt | 서버리스이나 컨테이너와 관련성 낮음 |
AKS와 Container Apps가 "container orchestration" 쿼리에 대해 최상위로 정확하게 랭킹되었다.
하이브리드 검색 — "serverless event-driven"
키워드 검색과 벡터 검색을 결합한 하이브리드 검색 결과:
curl -X POST "$SEARCH_URL/indexes/sample-vector-idx/docs/search?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "count": true, "search": "serverless event-driven",
    "select": "title, content",
    "vectorQueries": [{
      "kind": "text",
      "text": "serverless event-driven compute",
      "fields": "contentVector", "k": 3
    }]
  }'
| 순위 | Score | 문서 | 판단 |
|---|---|---|---|
| 1 | 0.0333 | azure-functions.txt | ✅ 서버리스 이벤트 드리븐 서비스 |
| 2 | 0.0328 | azure-container-apps.txt | 서버리스 컨테이너 |
| 3 | 0.0161 | azure-cosmos-db.txt | 관련성 낮음 |
Azure Functions가 "serverless event-driven" 쿼리에 1위로 정확히 랭킹되었다.
Custom Web API Skill 계약
/api/embed 엔드포인트는 Azure AI Search Custom Web API Skill 계약을 구현한다. AI Search가 인덱싱/쿼리 시 이 형식으로 호출하고 응답을 기대한다.
요청:
{
  "values": [
    {
      "recordId": "1",
      "data": { "text": "Azure Kubernetes Service manages clusters..." }
    }
  ]
}
응답:
{
  "values": [
    {
      "recordId": "1",
      "data": { "vector": [0.021, -0.013, ...] },
      "errors": null,
      "warnings": null
    }
  ]
}
📌
recordId는 AI Search가 배치 내 각 문서를 추적하는 데 사용한다. 요청의recordId를 응답에 그대로 반환해야 한다.
⚠️ 주의사항 및 흔한 함정
| # | 증상 | 원인 | 해결 |
|---|---|---|---|
| 1 | 인덱서 생성 시 Credentials provided in the connection string are invalid |
스토리지의 allowSharedKeyAccess: false (Azure Policy) |
ResourceId=/.../storageAccounts/{name}/; 형식으로 Managed Identity 인증 사용 |
| 2 | 인덱스 생성 시 httpHeaders contains headers that cannot be specified |
Vectorizer의 httpHeaders에 Content-Type 포함 |
httpHeaders 제거 — AI Search가 자동으로 설정함 |
| 3 | Custom Skill URI가 http://면 Only the https URI scheme is allowed |
AI Search는 Custom Web API Skill/Vectorizer에 HTTPS만 허용 | Container Apps (TLS 자동) 또는 AKS + cert-manager (Let's Encrypt) 사용 |
| 4 | Container Apps에서 Health probe 실패 후 재시작 반복 | BGE-M3 모델 로딩에 ~7초 소요 | min-replicas: 1로 설정하여 항상 Warm 상태 유지 |
| 5 | AKS Ingress에서 NSG가 443 포트를 차단 | MC_ 리소스 그룹의 NSG에 인바운드 규칙이 자동 생성되지 않음 | MC_ 리소스 그룹의 NSG에서 443 포트 인바운드 허용 확인 |
AI Search 오브젝트 구성
| 오브젝트 | 타입 | 설명 |
|---|---|---|
sample-vector-idx |
Index | id(key), title, content, contentVector(1024차원 HNSW cosine) |
bge-m3-vectorizer |
Vectorizer | 쿼리 시점 텍스트 → 벡터 변환 (Custom Web API) |
bge-m3-skillset |
Skillset | 인덱싱 시점 Custom Web API Skill로 벡터 생성 |
sample-docs-ds |
Data Source | Azure Blob + Managed Identity 인증 (ResourceId) |
sample-vector-indexer |
Indexer | Blob → Skillset → Index 파이프라인 |
임베딩 API 상세
embedding-api/app.py는 단일 파일 FastAPI 애플리케이션이다.
| 항목 | 값 |
|---|---|
| 모델 | EMBEDDING_MODEL 환경변수로 지정 (기본값: BAAI/bge-m3) |
| 벡터 차원 | 모델 의존 (BGE-M3: 1024, Qwen3-Embedding-0.6B: 1024) |
| 정규화 | L2 normalized |
| 로드 시간 | ~7초 (CPU, BGE-M3 기준) |
| 엔드포인트 | GET /health, POST /api/embed |
| 배치 처리 | Skill용: AI Search batchSize 설정에 따라 다수 레코드 동시 처리. Vectorizer용: 항상 1건씩 호출 |
Dockerfile
EMBEDDING_MODEL build arg로 모델을 지정한다. 빌드 타임에 모델 가중치를 다운로드하여 Cold start를 방지한다.
FROM python:3.11-slim

ARG EMBEDDING_MODEL=BAAI/bge-m3
ENV EMBEDDING_MODEL=${EMBEDDING_MODEL}

WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
# 빌드 타임에 모델 다운로드 → Cold start 방지
RUN python -c "from sentence_transformers import SentenceTransformer; SentenceTransformer('${EMBEDDING_MODEL}', trust_remote_code=True)"
COPY app.py .
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
다른 모델로 빌드하려면 --build-arg를 사용한다:
az acr build --registry acrexamplekrc01 \
  --image qwen3-embedding:latest \
  --build-arg EMBEDDING_MODEL=Qwen/Qwen3-Embedding-0.6B \
  --file embedding-api/Dockerfile embedding-api/
💡 Air-gapped 환경에서도 이 이미지를 사용하면 모델 다운로드 없이 서빙 가능하다.
🔧 Custom Chunking 적용
기본 구성에서는 문서 전체를 하나의 벡터로 변환한다. 문서가 길면 임베딩 토큰 제한에 걸리거나 검색 정밀도가 떨어진다. Chunking을 적용하면 문서를 작은 조각으로 분할하여 각각 독립된 벡터로 인덱싱하므로, 긴 문서에서도 관련 구간을 정밀하게 검색할 수 있다.
AI Search에서 Chunking을 적용하는 두 가지 방식을 다룬다:
| Option A: Built-in SplitSkill | Option B: Custom Web API Skill | |
|---|---|---|
| 구현 | AI Search 기본 제공 스킬 | FastAPI /api/chunk 엔드포인트 |
| 커스터마이징 | maximumPageLength, pageOverlapLength, textSplitMode |
자유 (sentence boundary, regex, semantic 등) |
| 코드 변경 | 없음 | app.py에 엔드포인트 추가 |
| 적합 사례 | 빠른 적용, 단순 분할 | 도메인 특화 분할 로직, 다국어 sentence split 등 |
두 방식 모두 Index Projections을 사용하여 1개 원본 문서 → N개 청크 인덱스 레코드 매핑을 처리한다.
공통: 청크 인덱스 스키마
청크 단위 인덱싱을 위해 인덱스 스키마를 변경한다. parent_id 필드로 원본 문서를 추적한다.
청크 인덱스 생성 curl
curl -X PUT "$SEARCH_URL/indexes/sample-chunk-idx?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "sample-chunk-idx",
    "fields": [
      {"name": "chunk_id", "type": "Edm.String", "key": true, "filterable": true},
      {"name": "parent_id", "type": "Edm.String", "filterable": true},
      {"name": "title", "type": "Edm.String", "searchable": true, "filterable": true},
      {"name": "chunk", "type": "Edm.String", "searchable": true},
      {"name": "chunkVector", "type": "Collection(Edm.Single)", "searchable": true,
       "dimensions": 1024, "vectorSearchProfile": "bge-m3-profile"}
    ],
    "vectorSearch": {
      "algorithms": [{"name": "hnsw-algo", "kind": "hnsw",
        "hnswParameters": {"m": 4, "efConstruction": 400, "efSearch": 500, "metric": "cosine"}}],
      "profiles": [{"name": "bge-m3-profile", "algorithm": "hnsw-algo",
        "vectorizer": "bge-m3-vectorizer"}],
      "vectorizers": [{
        "name": "bge-m3-vectorizer",
        "kind": "customWebApi",
        "customWebApiParameters": {
          "uri": "'$EMBED_URL'/api/embed",
          "httpMethod": "POST"
        }
      }]
    }
  }'
Option A. Built-in SplitSkill
AI Search가 기본 제공하는 #Microsoft.Skills.Text.SplitSkill을 사용한다. 코드 변경 없이 스킬셋 정의만으로 적용 가능하다.
스킬셋
SplitSkill → Custom Web API Embedding Skill 순서로 파이프라인을 구성한다. SplitSkill이 문서를 pages 배열로 분할하고, Embedding Skill이 각 page를 벡터로 변환한다.
SplitSkill + Embedding 스킬셋 curl
curl -X PUT "$SEARCH_URL/skillsets/bge-m3-chunk-builtin-skillset?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "bge-m3-chunk-builtin-skillset",
    "skills": [
      {
        "@odata.type": "#Microsoft.Skills.Text.SplitSkill",
        "name": "text-split",
        "context": "/document",
        "inputs": [{"name": "text", "source": "/document/content"}],
        "outputs": [{"name": "textItems", "targetName": "chunks"}],
        "textSplitMode": "pages",
        "maximumPageLength": 500,
        "pageOverlapLength": 100
      },
      {
        "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
        "name": "bge-m3-embedding-skill",
        "uri": "'$EMBED_URL'/api/embed",
        "httpMethod": "POST",
        "timeout": "PT60S",
        "batchSize": 10,
        "context": "/document/chunks/*",
        "inputs": [{"name": "text", "source": "/document/chunks/*"}],
        "outputs": [{"name": "vector", "targetName": "chunkVector"}]
      }
    ]
  }'
📌
textSplitMode는"pages"(문자 수 기반) 또는"sentences"(문장 단위) 중 선택한다.maximumPageLength는 기본적으로 문자 수 기준이다. Preview API(2024-09-01-preview+)에서는"unit": "azureOpenAITokens"를 설정하여 토큰 단위로 제어할 수도 있다.
인덱서 (Index Projections)
indexProjections를 사용하여 스킬셋이 생성한 청크 배열을 개별 인덱스 레코드로 매핑한다. projectionMode: "generatedKeyAsId"는 AI Search가 chunk_id를 자동 생성하도록 한다.
SplitSkill 인덱서 curl (Index Projections)
curl -X PUT "$SEARCH_URL/indexers/sample-chunk-builtin-indexer?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "sample-chunk-builtin-indexer",
    "dataSourceName": "sample-docs-ds",
    "targetIndexName": "sample-chunk-idx",
    "skillsetName": "bge-m3-chunk-builtin-skillset",
    "fieldMappings": [
      {"sourceFieldName": "metadata_storage_name", "targetFieldName": "title"}
    ],
    "outputFieldMappings": [],
    "parameters": {"configuration": {"parsingMode": "default"}},
    "indexProjections": {
      "selectors": [{
        "targetIndexName": "sample-chunk-idx",
        "parentKeyFieldName": "parent_id",
        "sourceContext": "/document/chunks/*",
        "mappings": [
          {"name": "chunk", "source": "/document/chunks/*"},
          {"name": "chunkVector", "source": "/document/chunks/*/chunkVector"},
          {"name": "title", "source": "/document/metadata_storage_name"}
        ]
      }],
      "parameters": {"projectionMode": "generatedKeyAsId"}
    }
  }'
Option B. Custom Web API Skill (직접 구현)
문장 경계(sentence boundary) 기반 분할, 정규식 기반 분할, 도메인 특화 로직 등 SplitSkill로 커버되지 않는 경우 Custom Web API Skill로 청킹을 직접 구현한다.
API 엔드포인트
embedding-api/app.py에 /api/chunk 엔드포인트를 추가한다. 문장 경계에서 overlap을 적용하는 방식으로 구현되어 있다.
Custom Chunking API 코드 + 설명
@app.post("/api/chunk")
def chunk(req: SkillRequest):
    """Custom Web API Skill contract endpoint for text chunking.

    Input  data field: {"text": "...", "chunkSize": 500, "overlap": 100}
    Output data field: {"chunks": ["chunk1", "chunk2", ...]}
    """
    results = []
    for v in req.values:
        text = v.data.get("text", "")
        size = v.data.get("chunkSize", CHUNK_SIZE)
        ovlp = v.data.get("overlap", CHUNK_OVERLAP)
        chunks = _split_text(text, chunk_size=size, overlap=ovlp)
        results.append({
            "recordId": v.recordId,
            "data": {"chunks": chunks},
            "errors": None,
            "warnings": None,
        })
    return {"values": results}
스킬셋
Custom Chunking Skill → Custom Embedding Skill 순서로 파이프라인을 구성한다.
Custom Chunking + Embedding 스킬셋 curl
curl -X PUT "$SEARCH_URL/skillsets/bge-m3-chunk-custom-skillset?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "bge-m3-chunk-custom-skillset",
    "skills": [
      {
        "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
        "name": "custom-chunk-skill",
        "uri": "'$EMBED_URL'/api/chunk",
        "httpMethod": "POST",
        "timeout": "PT30S",
        "batchSize": 10,
        "context": "/document",
        "inputs": [{"name": "text", "source": "/document/content"}],
        "outputs": [{"name": "chunks", "targetName": "chunks"}]
      },
      {
        "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
        "name": "bge-m3-embedding-skill",
        "uri": "'$EMBED_URL'/api/embed",
        "httpMethod": "POST",
        "timeout": "PT60S",
        "batchSize": 10,
        "context": "/document/chunks/*",
        "inputs": [{"name": "text", "source": "/document/chunks/*"}],
        "outputs": [{"name": "vector", "targetName": "chunkVector"}]
      }
    ]
  }'
인덱서 (Index Projections)
Built-in SplitSkill 방식과 동일한 Index Projections 구조를 사용한다.
Custom Chunking 인덱서 curl (Index Projections)
curl -X PUT "$SEARCH_URL/indexers/sample-chunk-custom-indexer?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "name": "sample-chunk-custom-indexer",
    "dataSourceName": "sample-docs-ds",
    "targetIndexName": "sample-chunk-idx",
    "skillsetName": "bge-m3-chunk-custom-skillset",
    "fieldMappings": [
      {"sourceFieldName": "metadata_storage_name", "targetFieldName": "title"}
    ],
    "outputFieldMappings": [],
    "parameters": {"configuration": {"parsingMode": "default"}},
    "indexProjections": {
      "selectors": [{
        "targetIndexName": "sample-chunk-idx",
        "parentKeyFieldName": "parent_id",
        "sourceContext": "/document/chunks/*",
        "mappings": [
          {"name": "chunk", "source": "/document/chunks/*"},
          {"name": "chunkVector", "source": "/document/chunks/*/chunkVector"},
          {"name": "title", "source": "/document/metadata_storage_name"}
        ]
      }],
      "parameters": {"projectionMode": "generatedKeyAsId"}
    }
  }'
청크 검색 검증
청크 인덱스에 대해 벡터 검색을 수행한다. 문서 단위 검색과 달리 관련 구간만 반환되므로 검색 정밀도가 높다.
curl -X POST "$SEARCH_URL/indexes/sample-chunk-idx/docs/search?api-version=2024-07-01" \
  -H "Content-Type: application/json" -H "api-key: $KEY" \
  -d '{
    "count": true, "select": "title, chunk, parent_id",
    "vectorQueries": [{
      "kind": "text",
      "text": "How does Azure handle container orchestration?",
      "fields": "chunkVector", "k": 5
    }]
  }'
parent_id로 원본 문서를 추적할 수 있고, chunk 필드에는 해당 구간의 텍스트만 포함된다.
⚠️ Chunking 관련 주의사항
| # | 증상 | 원인 | 해결 |
|---|---|---|---|
| 1 | 인덱서 실행 후 인덱스에 레코드가 생성되지 않음 | indexProjections가 누락되거나 sourceContext가 청크 배열과 불일치 |
sourceContext를 /document/chunks/*로 정확히 지정 |
| 2 | Embedding Skill에서 빈 텍스트 입력 | 청크 스킬의 output targetName과 Embedding Skill의 context/source 경로 불일치 |
청크 output의 targetName이 chunks이면 source는 /document/chunks/* |
| 3 | projectionMode 미설정 시 key 충돌 |
여러 청크가 동일한 원본 문서 key를 사용하려 함 | "projectionMode": "generatedKeyAsId" 설정 |
| 4 | SplitSkill maximumPageLength가 토큰이 아닌 문자 수 기준 |
임베딩 모델 토큰 제한(BGE-M3: 8192 토큰)과 단위가 다름 | 영문 기준 ~4자/토큰으로 환산하여 여유있게 설정 (예: 2000자 ≈ 500토큰). 또는 Preview API에서 "unit": "azureOpenAITokens"로 토큰 단위 직접 제어 가능 |
🚀 프로덕션 전환: TEI (Text Embeddings Inference)
대규모 인덱싱(수만 건 이상)이나 동시 쿼리가 많아지면, sentence-transformers 기반 서빙을 HuggingFace의 TEI로 교체하여 처리량을 높일 수 있다. TEI는 Rust로 작성된 임베딩 전용 추론 서버로, dynamic batching, Flash Attention, 양자화를 기본 지원한다.
sentence-transformers → TEI 전환 시 차이
TEI가 sentence-transformers보다 유리한 구조적 이유(dynamic batching, Rust 네이티브 동시성, GPU 최적화)는 Custom 임베딩 적재 가이드 — 서빙 엔진 비교 참고. 아래는 이 가이드(CPU 기본 구성) 기준의 실용적 차이:
| sentence-transformers (현재) | TEI | |
|---|---|---|
| 처리량 (CPU, 동일 하드웨어) | ~10 req/s | ~30-50 req/s |
| 이미지 크기 | ~3GB (모델 포함) | ~2GB (TEI) + ~50MB (어댑터) |
| 적합 시점 | 문서 수천 건 이하, 비정기 인덱싱 | 수만 건+, 동시 쿼리 다수 |
아키텍처
TEI의 API 형식(/embed)은 AI Search Custom Web API Skill 계약과 다르므로, 경량 어댑터(sidecar)로 변환한다.
Adapter와 TEI를 같은 Pod의 sidecar로 구성하면 네트워크 홉 없이 localhost로 통신한다.
1. 어댑터 이미지 빌드
어댑터는 모델을 포함하지 않으므로 빌드가 빠르다 (~30초).
az acr build --registry acrexamplekrc01 \
  --image tei-adapter:latest \
  --file tei-adapter/Dockerfile \
  tei-adapter/
2. TEI + Adapter 배포
tei-adapter/k8s/deployment.yaml은 TEI와 Adapter를 sidecar 패턴으로 같은 Pod에 배포한다.
TEI 컨테이너는 시작 시 HuggingFace Hub에서 모델을 다운로드한다. Air-gapped 환경이면 모델을 PVC에 미리 배치하고 --model-id=/models/bge-m3로 로컬 경로를 지정한다.
GPU 사용 시
deployment.yaml에서 TEI 이미지와 리소스를 변경한다:
# GPU 이미지 (T4/L4)
image: ghcr.io/huggingface/text-embeddings-inference:turing-1.9
# GPU 이미지 (A100/H100)
# image: ghcr.io/huggingface/text-embeddings-inference:1.9
resources:
  limits:
    nvidia.com/gpu: 1
3. Ingress 연결
기존 k8s/ingress.yaml에서 backend 서비스를 tei-bge-m3으로 변경하면 AI Search 스킬셋/벡터라이저의 URI 수정 없이 전환 가능하다.
# ingress.yaml 변경 (서비스 이름만 교체)
backend:
  service:
    name: tei-bge-m3    # 기존: bge-m3-embedding
    port:
      number: 80
4. 동작 확인
# Health check (TEI 상태 포함)
curl -s https://embed.{IP}.nip.io/health
# {"status":"ok","tei_status":200}

# 임베딩 테스트 (AI Search 계약 형식 — 기존과 동일)
curl -s -X POST https://embed.{IP}.nip.io/api/embed \
  -H "Content-Type: application/json" \
  -d '{"values":[{"recordId":"1","data":{"text":"test"}}]}'
AI Search 스킬셋/벡터라이저의 URI가 동일하므로, 인덱서를 재실행하면 TEI를 통해 벡터가 생성된다.
5. 롤백
Ingress의 backend 서비스를 bge-m3-embedding으로 되돌리면 즉시 sentence-transformers 기반으로 롤백된다.
⚠️ TEI 전환 시 주의사항
| # | 증상 | 원인 | 해결 |
|---|---|---|---|
| 1 | TEI 컨테이너가 OOMKilled | BGE-M3 로딩에 ~3.5GB 필요 | memory limit 8Gi 이상 설정 |
| 2 | TEI 시작 후 /health 502 | 모델 다운로드 + 로딩 시간 (~2분) | initialDelaySeconds: 60 이상 |
| 3 | Adapter가 TEI보다 먼저 Ready | TEI가 아직 모델 로딩 중 | Adapter의 /health가 TEI 상태를 확인하므로 readiness 자동 연동 |
| 4 | 벡터 차원이 달라짐 | TEI 기본값과 모델 설정 차이 | TEI --model-id가 동일 모델(BAAI/bge-m3)인지 확인 |
📋 관련 문서
- GPU vLLM RAG 가이드 — T4 GPU에서 vLLM + Push API 대량 적재 + 하이브리드 검색
- BGE-M3 vs Qwen3-Embedding-0.6B 비교 — 동일 파이프라인에서의 검색 품질 비교 결과
- Custom 임베딩 적재 가이드 — SKU 선택부터 서빙 엔진까지 의사결정 가이드
- 청킹 전략 리서치 — 7가지 최신 RAG 청킹 전략 비교 분석