Custom 임베딩 적재 가이드: SKU 선택부터 서빙 엔진까지
Azure AI Search의 SKU, 적재 방식과 GPU 임베딩 서빙 엔진 선택 기준을 설명합니다.
Azure AI Search에 벡터를 적재하는 두 가지 경로(Indexer Pull vs Push API)와, GPU 임베딩 서빙 엔진(TEI vs vLLM) 선택 기준
관련 문서: 기본 가이드 (CPU, Indexer) | GPU vLLM RAG 가이드 | 청킹 전략 리서치
작성일: 2026-05-22
핵심 요약
| Indexer (Pull) | Push API | |
|---|---|---|
| 적재 방식 | AI Search가 주도 | 내 코드가 주도 |
| 임베딩 엔진 | sentence-transformers / TEI / vLLM | TEI / vLLM |
| 동시성 상한 | degreeOfParallelism ≤ 10 | 내가 제어 (Indexer보다 유연) |
| 시간 제한 | 공용 2h / 전용 24h (Basic 이상) | 없음 (배치 1,000건·16MB, throttling 존재) |
| 스킬 간 파이프라이닝 | ✗ | ✅ 청킹+임베딩 동시 |
| 자동 변경 감지 | ✅ (데이터 소스 연동) | ✗ (직접 구현 필요) |
| 운영 복잡도 | ★☆☆ (설정 기반) | ★★☆ (코드 필요) |
| 적합 시점 | 소규모, 증분, 운영 최소화 | 대규모 일괄, 성능 중시 |
임베딩이 빠른 경량 모델 + GPU 환경에서는, Indexer의 오케스트레이션 오버헤드(degreeOfParallelism 10, 스킬 간 순차)가 상대적 병목이 될 수 있다. 반면 7B급 대형 임베딩 모델이나 긴 시퀀스를 처리할 때는 추론 자체가 지배적이므로 Indexer의 오버헤드는 크지 않다.
1. AI Search 티어별 제약과 선택 기준
Custom Web API Skill이나 Push API로 외부 GPU 임베딩을 사용할 때, AI Search의 SKU(티어)는 적재 방식, 네트워크 구성, 벡터 저장 용량에 직접 영향을 준다. 아래 표는 최신 구간(스토리지/벡터 quota는 2024-05-17 이후, 기타 제한은 최신 공식 값) 기준이며, 서비스 생성 시점·리전에 따라 다를 수 있다. 전체 목록은 Service limits in Azure AI Search 참고.
Indexer·Skill 제약
| 항목 | Free | Basic | S1 | S2 | S3 | S3 HD¹ | L1 | L2 |
|---|---|---|---|---|---|---|---|---|
| 최대 인덱서 / 스킬셋 | 3 | 5 or 15³ | 50 | 200 | 200 | — | 10 | 10 |
| 인덱서 실행 시간 (공용 / 전용) | 1-3분⁴ | 2h / 24h | 2h / 24h | 2h / 24h | 2h / 24h | — | 2h / 24h | 2h / 24h |
| 호출당 최대 문서 | 10,000 | 무제한 | 무제한 | 무제한 | 무제한 | — | 무제한 | 무제한 |
| 스킬셋 + Private Endpoint | ✗ | ✗ | ✓ | ✓ | ✓ | — | ✓ | ✓ |
| 임베딩 스킬 + Private Endpoint | ✗ | ✓ | ✓ | ✓ | ✓ | — | ✓ | ✓ |
| 최대 Private Endpoint | — | 10 or 30³ | 100 | 400 | 400 | — | 20 | 20 |
스케일·용량
| 항목 | Free | Basic | S1 | S2 | S3 | S3 HD | L1 | L2 |
|---|---|---|---|---|---|---|---|---|
| 최대 파티션 | — | 3 | 12 | 12 | 12 | 3 | 12 | 12 |
| 최대 레플리카 | — | 3 | 12 | 12 | 12 | 12 | 12 | 12 |
| 최대 SU (R×P) | — | 9 | 36 | 36 | 36 | 36 | 36 | 36 |
| 파티션 스토리지 | 50MB | 15 GB | 160 GB | 512 GB | 1 TB | 1 TB⁵ | 2 TB | 4 TB |
| 벡터 인덱스 / 파티션 | — | 5 GB | 35 GB | 150 GB | 300 GB | 300 GB⁵ | 150 GB | 300 GB |
| 벡터 인덱스 총 용량² | — | 15 GB | 420 GB | 1.8 TB | 3.6 TB | 900 GB⁵ | 1.8 TB | 3.6 TB |
¹ S3 HD는 인덱서를 지원하지 않는다. Push API로만 데이터 적재 가능.
² 벡터 인덱스/파티션 × 최대 파티션 수. SU 상한(36)에 의해 파티션과 레플리카 조합이 제한된다 (e.g., 12P 사용 시 레플리카 최대 3).
³ Basic은 서비스 생성 시점에 따라 값이 다르다 (레거시: 5/10, 최신: 15/30).
⁴ Free는 데이터 소스에 따라 1-3분이며, 스킬셋이 포함된 경우 3-10분.
⁵ S3 HD는 공식 표에서 S3/HD로 합산되어 파티션당 값은 S3과 동일하나, 최대 파티션이 3개이므로 총 용량이 다르다 (300 GB × 3 = 900 GB).Throttling: Push API(문서 인덱싱) throttling은 서비스 부하에 따라 동적으로 적용된다. 인덱스 관리 작업(Create/Update Index 등)에는 별도의 고정 rate limit이 존재한다. 일반적으로 SKU가 높고 SU가 많을수록 전체 처리 용량이 커져 동시 적재 여유가 증가한다.
적재 방식 선택 기준
적재 방식은 처리량뿐 아니라 운영 복잡도, 팀 역량, 변경 감지 요구사항을 함께 고려해야 한다.
| 기준 | Indexer가 유리 | Push API가 유리 |
|---|---|---|
| 문서 수 | 수천 건 이하 | 수만 건 이상 |
| 변경 패턴 | 자동 증분 필요 | 일괄 적재 또는 이벤트 드리븐 |
| 운영 인력 | 적음 (코드 없이 설정만) | 개발/운영 가능한 팀 |
| 시간 제약 | 공용 2h / 전용 24h 내 완료 가능 | 시간 제한 초과 예상 |
| 커스텀 파이프라인 | 불필요 | 청킹/임베딩 세밀 제어 필요 |
| 규모 | 적재 방식 | 임베딩 엔진 | 비고 |
|---|---|---|---|
| 소규모 (~수천 건) | Indexer | CPU: TEI cpu-1.9 |
자동 변경 감지, 코드 불필요 |
| 중간 (~수만 건) | Indexer 또는 Push API | GPU: TEI (T4/L4) | 요구사항에 따라 선택 |
| 대규모 (~수십만 건) | Push API | GPU: TEI (A100+) | 인덱서 시간 제한 초과 가능 |
| LLM 청킹 필요 | Push API | GPU: vLLM | 임베딩+생성 통합 |
하이브리드 운영 패턴
실제 운영에서는 Indexer와 Push API를 병행하는 것이 일반적이다.
| 상황 | 적재 방식 |
|---|---|
| 초기 대량 적재 (수만 건+) | Push API — 인덱서 시간 제한 초과 가능 |
| 일상 증분 업데이트 (수백 건/일) | Indexer — 자동 변경 감지, 코드 불필요 |
| 실시간 반영 필요 | Push API (이벤트 드리븐: Change Feed → Function → Push) |
| 운영 인력/코드 최소화 | Indexer — 설정만으로 관리 |
| 청킹/임베딩 세부 제어 필요 | Push API — 배치 크기, 동시성 등 직접 튜닝 |
2. 적재 방식: Indexer vs Push API
Indexer (Pull) — Custom Skill 호출 구조
Batch 1: [doc1...doc20]
  ├─ Skill 1 (/api/chunk) ── 완료 대기 ──┐
  │   degreeOfParallelism: 최대 10       │ 스킬 간 순차
  ├─ Skill 2 (/api/embed) ── 완료 대기 ──┘
  └─ Index에 쓰기

Batch 2: [doc21...doc40]
  ├─ Skill 1 ...
  ...
인덱서 전체가 완전 직렬인 것은 아니다 — 배치 내에서 degreeOfParallelism만큼 병렬 호출하고, SKU에 따라 내부 병렬 처리도 일부 존재한다. 하지만 Custom Skill 간의 호출은 순차이며, degreeOfParallelism이 최대 10으로 제한되므로 GPU 추론 서버의 동시 처리 능력을 충분히 활용하기 어렵다.
병목이 되는 조건
인덱서의 오케스트레이션 오버헤드(배치 관리, HTTP 왕복, 인덱스 쓰기, 체크포인팅)는 임베딩 속도와 무관하게 일정하다. 따라서:
- 경량 모델 + GPU (e.g., BGE-M3, Qwen3-Embedding-0.6B): 추론이 수 ms로 끝나면 인덱서 오버헤드가 상대적 병목
- 대형 모델 (e.g., 7B 임베딩 모델) 또는 긴 시퀀스: 추론 자체가 지배적이므로 인덱서 오버헤드는 무시 가능
| 제약 | 값 | 영향 |
|---|---|---|
degreeOfParallelism |
최대 10 | 스킬 엔드포인트 동시 호출 수 제한 |
| 스킬 간 처리 | 순차 | 청킹 스킬 완료 후 임베딩 스킬 시작 |
| 실행 시간 제한 | 공용 2h / 전용(private) 24h | Free: 1-3분. 대량 적재 시 초과 가능 |
Push API — 인덱서 우회
AI Search의 Push API는 POST /indexes/{index}/docs/index로 직접 문서를 적재한다. 인덱서를 거치지 않으므로 인덱서 고유 제약(deg≤10, 스킬 간 순차, 실행 시간 제한)이 없다. 단, Push API 자체 제약(요청당 최대 1,000건 / 16MB, throttling)은 존재한다.
📖 Push API 상세: Add, Update or Delete Documents (REST API)
아키텍처 비교
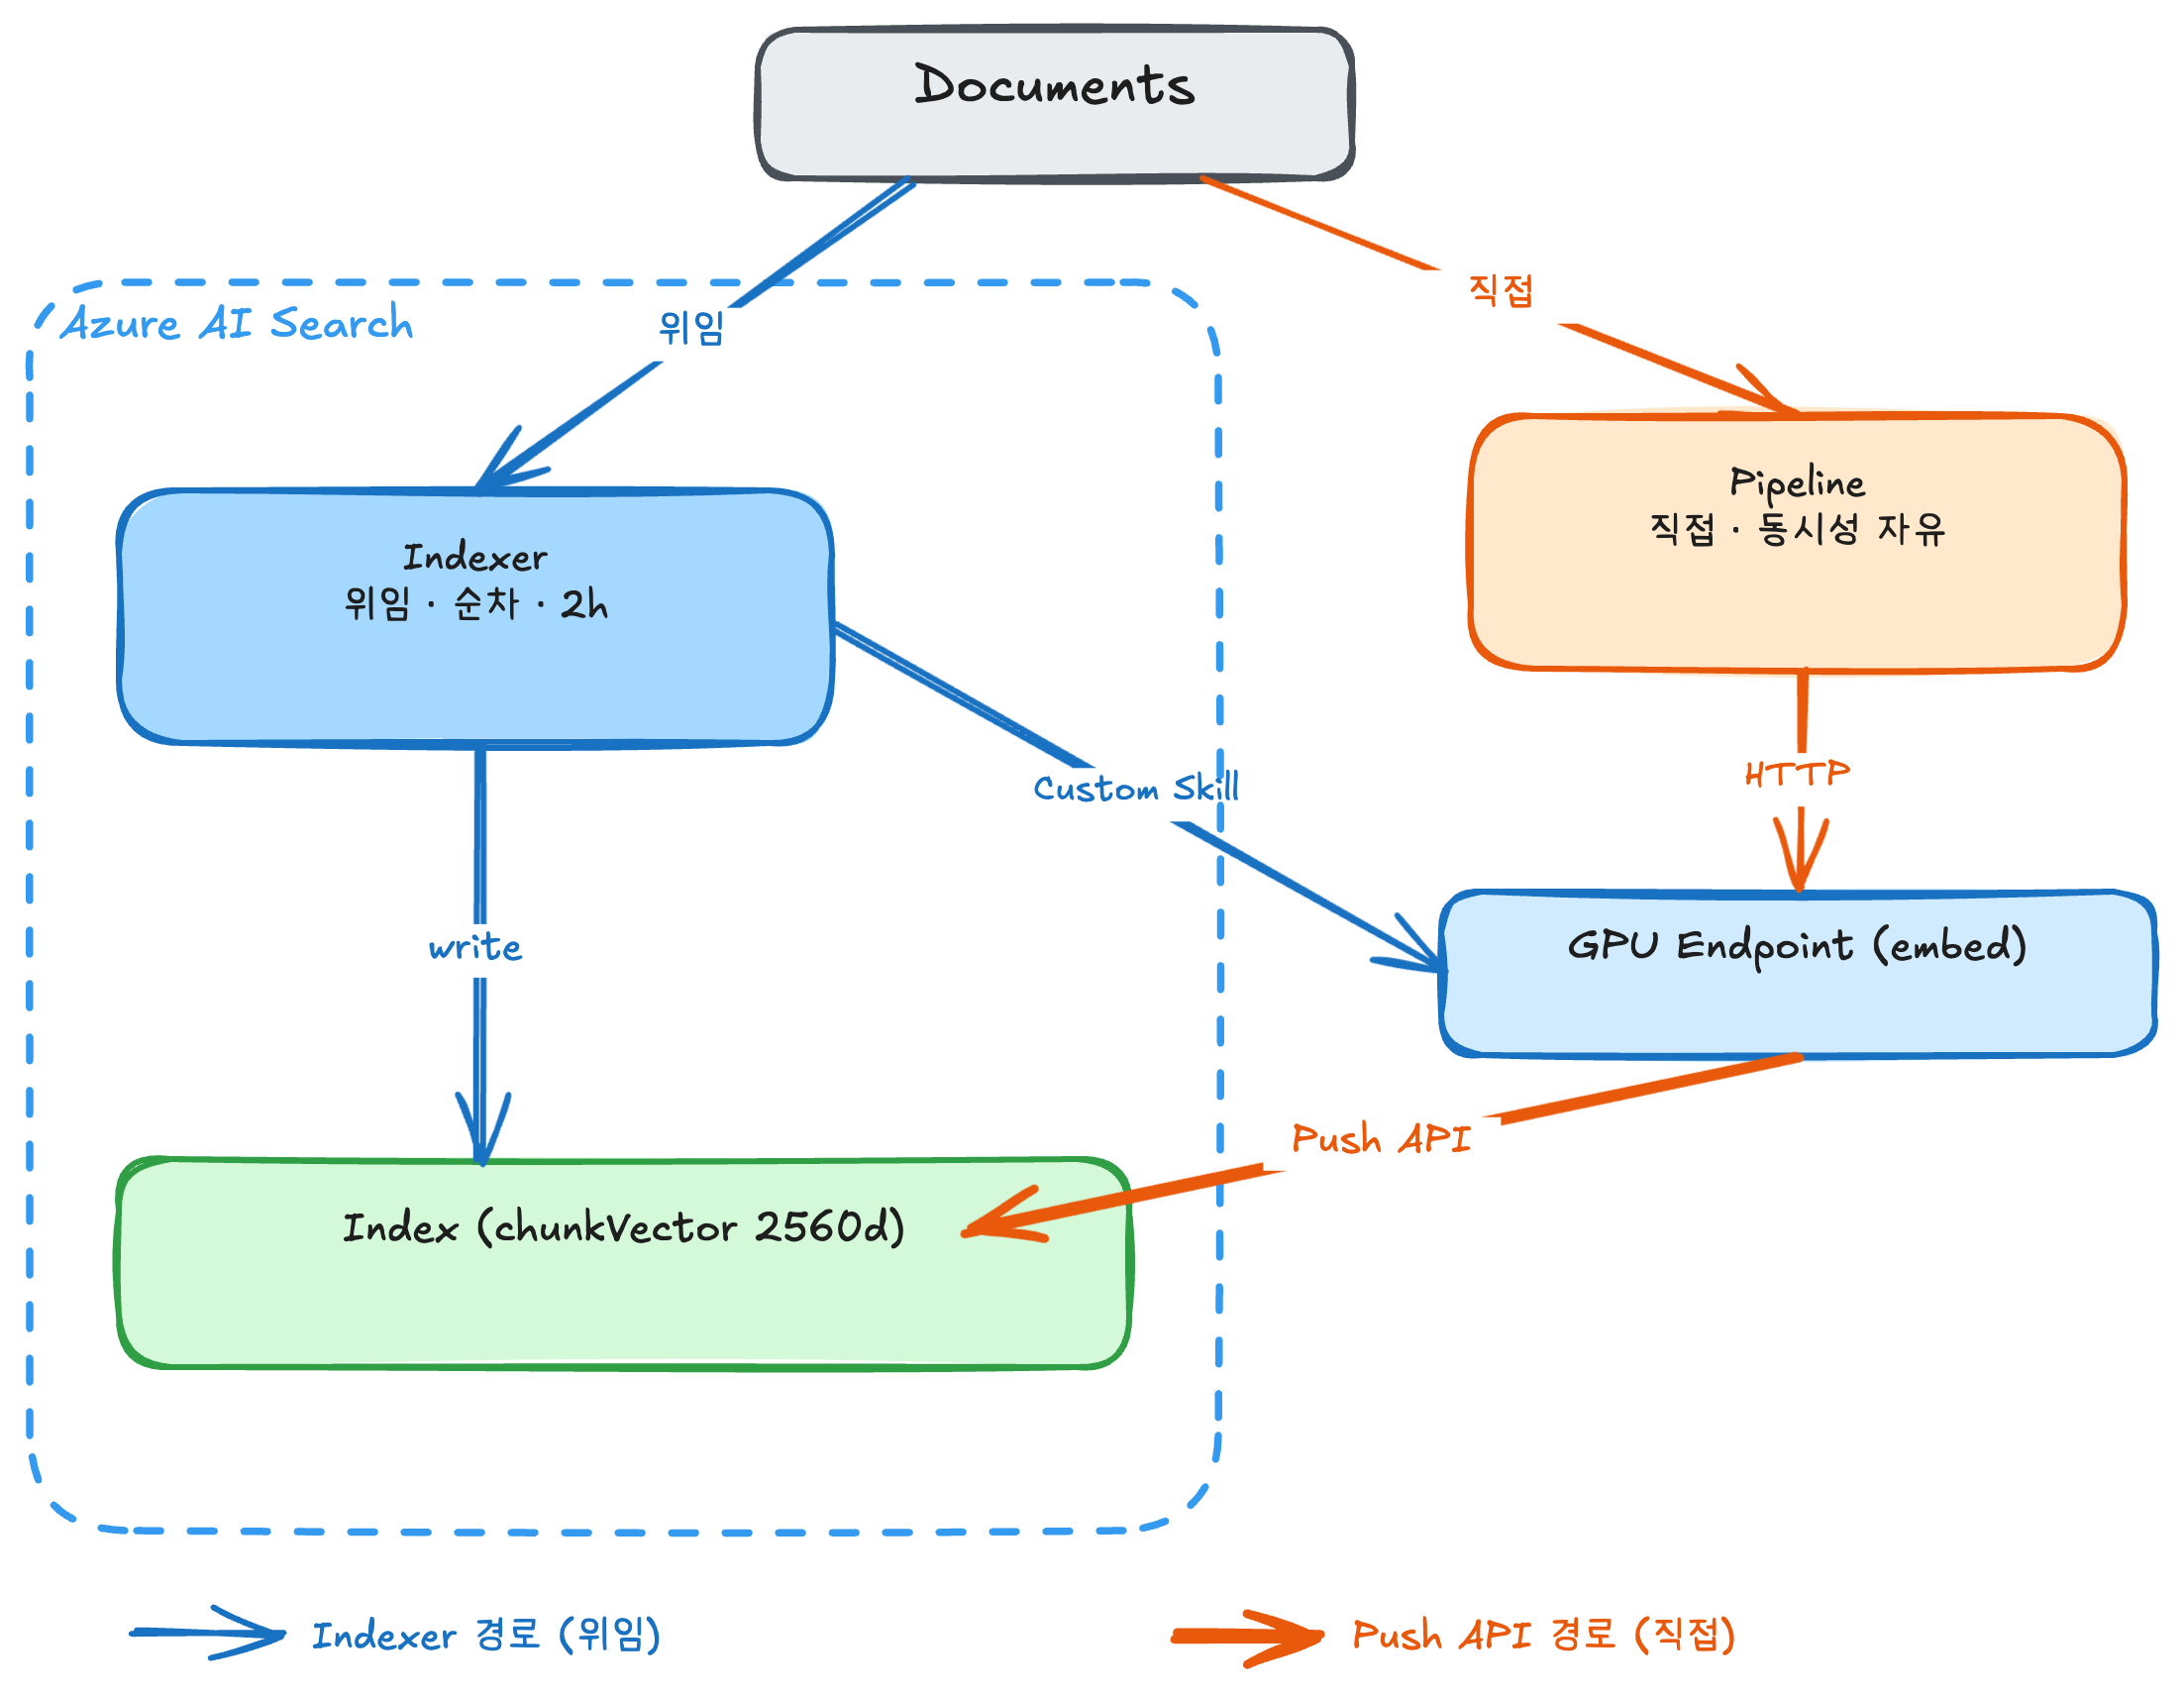
Push API 성능이 높은 이유
Indexer:                               Push Pipeline:

  doc1: chunk ─── wait ─── embed        doc1: chunk ──┐
  doc2:           wait                  doc2: chunk ──┤── embed batch ── push
  doc3:                    wait         doc3: chunk ──┤
  ...                                   doc4: chunk ──┘
                                        doc5: chunk ──┐
  순차, 대기 시간 많음                     doc6: chunk ──┤── embed batch ── push
                                        ...            파이프라이닝 + 배치
- 파이프라이닝: doc1 임베딩 중에 doc5 청킹 동시 진행
- 동시성 유연: Indexer의 degreeOfParallelism(≤10)에 비해 자유롭게 조절 가능. 단, 실제 처리량은 GPU 처리 속도, Search 인덱싱 QPS(throttling), 배치 전략 중 최소값에 수렴한다
- 배치 크기 자유: Push API는 요청당 최대 1,000건 또는 16MB
- 네트워크 오버헤드 감소: 동일 클러스터 내부 통신 시 네트워크 hop이 줄어 지연 감소 (TLS 적용 여부는 보안/서비스 메시 구성에 따라 달라진다)
- 실행 시간 제한 없음: 인덱서의 실행 시간 제한(공용 2h / 전용 24h)이 없어 대량 적재 가능
Push API 파이프라인 코드 예시는 Appendix A 참고.
쿼리 시점: Custom Vectorizer (변경 없음)
Push API는 인덱싱(적재) 시점만 대체한다. 쿼리 시점에는 여전히 Custom Web API Vectorizer가 텍스트 → 벡터 변환을 수행한다.
⚠️ Vectorizer는 항상 1건씩 호출한다: Skill은
batchSize로 다수 레코드를 한 번에 전송하지만, Vectorizer는values배열에 항상 1건만 담아 보낸다. 어댑터는 배치 처리를 가정하지 말고 단건 레이턴시에 최적화해야 한다.⚠️ Vectorizer 에러 처리: Custom Vectorizer 엔드포인트가 에러/경고를 반환해도 AI Search는 쿼리 응답에 노출하지 않는다. 임베딩 서비스 장애 시 벡터 검색이 조용히 실패하므로, 엔드포인트 헬스체크와 별도 모니터링이 필수다.
3. GPU 임베딩 서빙 엔진: TEI vs vLLM
GPU 환경에서 동시 요청이 많은 서빙 시, 전용 추론 서버가 유리한 이유:
| sentence-transformers | TEI | vLLM | |
|---|---|---|---|
| 동시성 처리 | Python 단일 프로세스 | Rust 네이티브 동시성 | C++/CUDA 네이티브 |
| 배칭 | 수동 또는 별도 구현 필요 | 자동 dynamic batching | 자동 continuous batching |
| GPU 최적화 | PyTorch 기본 | Flash Attention 2, cuBLASLt | PagedAttention |
| CPU 지원 | ✅ | ✅ | ✅ (제한적) |
| 임베딩 전용 설계 | ✅ | ✅ (Rust 최적화) | ❌ (LLM 생성이 주 목적) |
| AI Search 계약 | 직접 구현 | 어댑터 필요 | 어댑터 필요 |
| 운영 복잡도 | ★☆☆ | ★★☆ | ★★★ |
처리량 비교는 모델 크기, 시퀀스 길이, GPU 종류, 동시 요청 수에 따라 크게 달라진다. TEI는 공식 벤치마크에서 높은 처리량을 보여주지만, 조건별 차이가 크므로 실제 워크로드로 실측이 필요하다.
sentence-transformers vs 전용 추론 서버
sentence-transformers로도 배치 처리(model.encode(batch))나 multiprocessing으로 처리량을 높일 수 있다. 단순 배치 추론이나 소규모 환경에서는 충분히 실용적이다.
그러나 동시 요청이 많은 서빙 환경에서는 한계가 있다:
- 요청별 개별 encode() 호출 구조로 서버 레벨의 dynamic batching이 어려움
- 다수 요청을 GPU 배치로 합성하려면 별도 큐 구현이 필요
- Python 단일 프로세스 특성상 전후 처리(토크나이징, 텐서 변환)의 동시성이 제한될 수 있음
TEI/vLLM은 요청을 내부 큐에 쌓고 GPU에 최적화된 배치로 합성하여 처리한다. 동시 요청이 많을수록 이 자동 배칭의 효과가 커진다.
TEI vs vLLM 선택 기준
                     TEI                              vLLM
                     ─────────────────                ─────────────────
설계 목적            임베딩 전용                        LLM 생성 + 임베딩
핵심 기술            Flash Attention 2                 PagedAttention
                    Rust dynamic batching             continuous batching
텍스트 생성          ✗                                 ✅ (PIC 요약 등)
Qwen3 호환          ✅ (v1.9+, T4에선 최적화 미흡)     ✅ (PyTorch 직접 로딩)
이미지 크기          ~2GB                              ~5GB+
| 시나리오 | 선택 |
|---|---|
| 임베딩만 필요 (BGE-M3 등 검증된 모델) | TEI — 임베딩 전용 최적화, 운영 단순 |
| 임베딩 + LLM 생성 (PIC 청킹 등) | vLLM — 임베딩과 생성을 한 서버에서 |
| Qwen3-Embedding 등 신규 아키텍처 | vLLM 우선 — TEI v1.9+에서 Qwen3 지원하나, T4에서 vLLM 대비 21% 느림 (최적화 커널 미흡) |
| CPU에서 임베딩 | TEI — Rust 네이티브, CPU 전용 이미지 제공. vLLM도 CPU를 지원하나 GPU 최적화가 주 목적 |
GPU별 TEI Docker 이미지 (v1.9 기준)
| GPU | TEI 이미지 |
|---|---|
| T4 (Turing) | ghcr.io/huggingface/text-embeddings-inference:turing-1.9 |
| A100 / A30 (Ampere 8.0) | ghcr.io/huggingface/text-embeddings-inference:1.9 |
| A10 / A40 (Ampere 8.6) | ghcr.io/huggingface/text-embeddings-inference:86-1.9 |
| H100 (Hopper) | ghcr.io/huggingface/text-embeddings-inference:hopper-1.9 |
| CPU | ghcr.io/huggingface/text-embeddings-inference:cpu-1.9 |
최신 이미지 목록: TEI Docker Images
4. AI Search 어댑터
TEI/vLLM 모두 AI Search Custom Web API Skill 계약과 API 형식이 다르므로 어댑터가 필요하다.
API 형식 비교
| AI Search 계약 | TEI | vLLM | |
|---|---|---|---|
| 엔드포인트 | Custom Skill/Vectorizer | POST /embed |
POST /v1/embeddings |
| 요청 | {"values": [{"recordId": "1", "data": {"text": "..."}}]} |
{"inputs": ["text1", "text2"]} |
{"model": "...", "input": ["text1"]} |
| 응답 | {"values": [{"recordId": "1", "data": {"vector": [...]}}]} |
[[0.021, ...], [0.045, ...]] |
{"data": [{"embedding": [...]}]} |
어댑터 역할
AI Search (또는 Push Pipeline)
    │  AI Search 계약 형식
    ▼
Adapter (FastAPI, 경량)
    │  recordId 매핑 + 필드 변환
    ▼
TEI / vLLM (추론 서버)
어댑터는 JSON 변환만 수행하며 모델을 로딩하지 않는다. 추론 서버와 같은 Pod의 sidecar로 배치하여 localhost 통신한다.
Push API를 사용할 때: Push Pipeline 코드가 직접 TEI/vLLM API를 호출하면 어댑터가 불필요하다. 어댑터는 AI Search Vectorizer(쿼리 시점)를 위해서만 필요하다.
인덱싱 (Push):                              쿼리 (Vectorizer):
  Push Pipeline ──HTTP──▶ TEI /embed         AI Search ──HTTPS──▶ Adapter /api/embed
  (내 코드에서 직접 호출)    (어댑터 불필요)                             ↓ localhost
                                              TEI /embed
                                              (어댑터 필요: 쿼리 시점)
어댑터 구현 예시: tei-adapter 디렉토리 참고
5. 전환 경로
CPU Indexer (현재, sentence-transformers)
  │
  ├── 소규모 + 운영 최소화 ──▶ TEI CPU + Indexer
  │     CPU에서도 Rust 네이티브로 처리량 향상
  │     자동 변경 감지 유지, 코드 변경 최소
  │
  ├── 대규모 일괄 적재 ─────▶ TEI/vLLM GPU + Push API
  │     인덱서 시간/동시성 제약 해소
  │     Ingress에 어댑터 유지 (쿼리 시점 Vectorizer용)
  │
  └── LLM 청킹 필요 ───────▶ vLLM GPU + Push API
        PIC 요약, Contextual Retrieval 등
        임베딩 + 생성을 한 서버에서
⚠️ 주의사항
| # | 항목 | 설명 |
|---|---|---|
| 1 | Push API 변경 감지 | Push API는 자동 변경 감지가 없다. 변경 추적을 직접 구현하거나, 증분용 Indexer를 병행한다 |
| 2 | Push API throttling | Push API도 Azure Search의 인덱싱 API throttling을 받는다. 동시성을 높일 때 429 응답 재시도 로직 필요 |
| 3 | vLLM 임베딩 모드 | 최근 vLLM에서는 임베딩/리랭커 등 pooling 계열에 --runner pooling 사용이 권장된다. 모델/버전에 따라 task 자동 선택 동작이 다를 수 있으므로 실행 로그에서 supported tasks(예: embed) 확인 권장 |
| 4 | 벡터 차원 일치 | 인덱스 dimensions와 모델 출력 차원 일치 필수 (BGE-M3: 1024) |
| 5 | 정규화 | TEI: normalize: true, vLLM: 모델 의존. cosine 검색 시 L2 정규화 필수 |
| 6 | Push API 배치 제한 | 요청당 최대 1,000건 또는 16MB. 대량 적재 시 배치 분할 필요 |
| 7 | 쿼리 시점 어댑터 | Push API로 적재해도 Custom Vectorizer(쿼리 시점)용 어댑터는 유지해야 함 |
| 8 | Vectorizer 에러 무노출 | Custom Vectorizer 엔드포인트가 에러/경고를 반환해도 쿼리 응답에 노출되지 않는다. 임베딩 서비스 장애 시 벡터 검색이 조용히 실패하므로, 엔드포인트 헬스체크와 별도 모니터링 필수 |
| 9 | 콜드스타트 | TEI/vLLM 모두 모델 로딩에 수 분 소요. min-replicas: 1 또는 PVC 모델 캐시 권장 |
참고
- Azure AI Search Push API — 데이터 가져오기 개요
- Push API — Add/Update/Delete Documents (REST)
- Azure AI Search 제한 및 할당량
- Custom Web API Skill 계약
- Custom Web API Vectorizer
- Text Embeddings Inference (TEI)
- vLLM Embedding Models
Appendix A. Push API 파이프라인 코드 예시
전체 파이프라인
"""Push API Pipeline — GPU 임베딩 + 청킹 + AI Search 직접 적재."""

import asyncio
import httpx

SEARCH_URL = "https://<search>.search.windows.net"
INDEX_NAME = "prod-chunk-idx"
API_KEY = "<api-key>"
GPU_URL = "http://gpu-endpoint:8080"  # 클러스터 내부 HTTP

sem = asyncio.Semaphore(50)  # GPU 동시 요청 제어


async def process_and_push(client: httpx.AsyncClient, doc: dict):
    """문서 1건 → 청킹 → 임베딩 → Push API 적재."""
    async with sem:
        # 1. 청킹
        chunk_resp = await client.post(f"{GPU_URL}/api/chunk", json={
            "values": [{"recordId": "1", "data": {"text": doc["content"]}}]
        })
        chunks = chunk_resp.json()["values"][0]["data"]["chunks"]

        if not chunks:
            return

        # 2. 임베딩 (배치)
        embed_resp = await client.post(f"{GPU_URL}/api/embed", json={
            "values": [
                {"recordId": str(i), "data": {"text": c}}
                for i, c in enumerate(chunks)
            ]
        })
        vectors = [v["data"]["vector"] for v in embed_resp.json()["values"]]

        # 3. Push API 적재
        index_docs = [{
            "chunk_id": f"{doc['id']}_chunk_{i}",
            "parent_id": doc["id"],
            "title": doc.get("title", ""),
            "chunk": c,
            "chunkVector": v,
            "@search.action": "mergeOrUpload",
        } for i, (c, v) in enumerate(zip(chunks, vectors))]

        await client.post(
            f"{SEARCH_URL}/indexes/{INDEX_NAME}/docs/index?api-version=2024-07-01",
            json={"value": index_docs},
            headers={"api-key": API_KEY, "Content-Type": "application/json"},
        )


async def run(documents: list[dict]):
    async with httpx.AsyncClient(timeout=120.0) as client:
        tasks = [process_and_push(client, doc) for doc in documents]
        await asyncio.gather(*tasks)
TEI / vLLM 직접 호출 (어댑터 없이)
# TEI
async def embed_texts_tei(client: httpx.AsyncClient, texts: list[str]) -> list[list[float]]:
    r = await client.post(
        "http://tei-embedding-svc:8080/embed",
        json={"inputs": texts, "normalize": True},
    )
    r.raise_for_status()
    return r.json()  # [[0.021, ...], [0.045, ...]]


# vLLM
async def embed_texts_vllm(client: httpx.AsyncClient, texts: list[str]) -> list[list[float]]:
    r = await client.post(
        "http://vllm-embedding-svc:8080/v1/embeddings",
        json={"model": "Qwen/Qwen3-Embedding-0.6B", "input": texts},
    )
    r.raise_for_status()
    data = sorted(r.json()["data"], key=lambda x: x["index"])
    return [d["embedding"] for d in data]